Как я наводил порядок в блоге длиной 20 лет с помощью ИИ или почему разметка «в лоб» ломает контекст длинной истории.
В выходные выделил время, чтобы навести порядок в одном из своих старрых проектов. Для меня это отличная площадка для наработки опыта работы с AI-агентами и поиска реальных сценариев применения LLM. Проект — блог «ленивого фермера», который автор ведет в удобном ему формате HTML файлов с 2005 года. Это настоящий дневник: записи вносятся дисциплинированно и ежедневно уже почти 20 лет.
Моя задача — перенести статьи в WordPress, настроить навигацию и сделать чтение удобнее. Сегодня я решал конкретную проблему: тегирование всех ранее загруженных записей. В процессе применял два разных подхода.
Подход 1. Тегирование «в лоб»
Схема простая: текст записи передается LLM вместе со списком существующих тегов и промптом.
«`python
Ты — ассистент по тегированию записей блога.У тебя есть список тегов.
Выдели до 3 ключевых мыслей текста. Для каждой выбери тег из списка. Тег может состоять из нескольких слов. Копируй название точно как в списке.
Если хотя бы один тег из списка подходит — верни только теги из списка.
Если ни один тег из списка категорически не подходит, верни ровно одну строку:
+Название нового тега
Плюс в начале обязателен. Это сигнал, что список не подошёл. Название — короткая русская фраза без точки.
Не придумывай новый тег, если подходит хотя бы один существующий.От 0 до 3 уникальных тегов. Если мыслей нет — пустая строка.
«`
Список тегов для начала я взял из блога и тех записей, что были размечены вручную ранее. Пополнение списка Gigachat делает самостоятельно. Для автоматизации я разрабатываю Python-скрипты и веб-интерфейс в Cursor, но сегодня речь не о вайбкодинге.
Покажу воркфлоу в n8n, который обрабатывает саму запись:
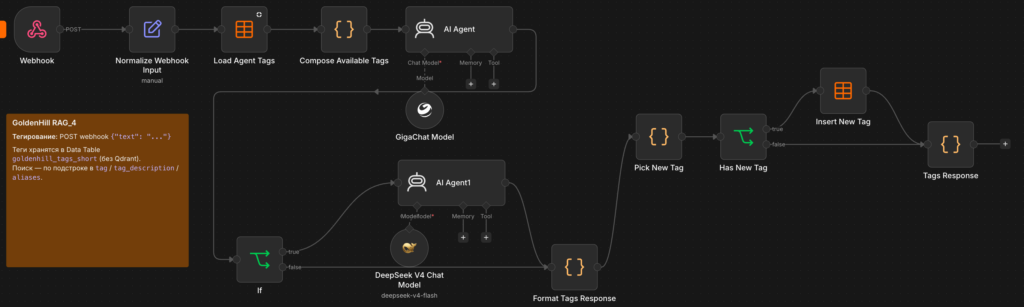
Проблема первого подхода в том, что при разметке большого массива данных модель теряет контекст. В ее распоряжении только список тегов и один изолированный пост. Блог фермера — это длинная, развивающаяся история. Запись о ремонте трактора сегодня может быть сюжетным продолжением поста о покупке запчастей месяц назад. Также как и историю про щенков и лечение котов. Модель «в лоб» этого не видит. Она тегирует факт (трактор), но теряет сюжетную связь.
Подход 2. Формирование «облака тегов историй»
Чтобы сохранить контекст, нужно сначала научить модель понимать глобальные сюжеты блога. Для этого я планирую:
1. Выгрузить записи блога по годам в отдельные файлы (например, `2005.md`, `2006.md`).
2. Попросить GigaChat проанализировать каждый файл, выделить сквозные истории и сформулировать для них теги. Для этой задачи я воспользуюсь пополнением лимита GigaChat Ultra на 50 000 000 подаренных токенов на developers.sber.ru
3. Добавить полученные теги историй в общий список.
4. Доработать промпт агента и запустить повторную разметку всего массива.
В перспективе для этих меток можно создать в WordPress отдельную таксономию — «Истории». Но это задача на следующий заход.
Работа с большим объемом текстовых данных требует от ИИ не просто поиска ключевых слов, а понимания нарратива. Первый подход хорош для новостных лент, второй — для дневников и лонгридов.
Кстати, если вам стало интересно посмотреть, каким проектом можно заниматься больше 20 лет, заходите на обновленную версию сайта: goldenhill.ru/wp.
Буду рад обратной связи по проекту и вашим мыслям о том, как еще можно структурировать подобные архивы.